Kev: el modelo abierto que clasifica textos y te dice cuándo no está seguro
Read this article in English.
Imagina que llegan 4.000 correos de soporte al día y cada uno tiene que acabar en el equipo correcto. Lo habitual hoy es pedírselo a un modelo de lenguaje: se escribe un prompt, se le pide un JSON y vuelve {"equipo": "facturación"}.
A escala aparece el problema de fondo. Esa respuesta no dice si el modelo estaba seguro o si tiraba una moneda al aire, y sin ese dato no hay forma de decidir qué se automatiza y qué tiene que revisar una persona.
Kev es un modelo abierto pensado para ese hueco. Lee un texto y, en lugar de redactar una respuesta, reparte una probabilidad entre las opciones de cada pregunta que le hagas.
Para este artículo partimos de una evaluación técnica que lo sometió a ocho experimentos en una GPU de consumo, reprodujimos esos experimentos en un Mac con chip M4 Pro y contrastamos las cifras con las que publica el proyecto.
Nuestra conclusión es que, si tus textos no deben salir de tu infraestructura, Kev merece un piloto para clasificarlos con un umbral de confianza, aunque todavía no conviene adoptarlo como infraestructura general. Si pueden salir, el servicio comercial al que replica es más barato y acierta más.
Índice
- Qué es Kev, en cristiano
- Por qué una probabilidad vale más que una etiqueta
- Cómo funciona por dentro
- Lo que medimos en nuestro hardware
- En qué escenarios encaja en una empresa
- Kev frente a Jev: acierto, coste y control
- Dónde no encaja
- Cómo hacer un piloto
- Fuentes
Qué es Kev, en cristiano
Un modelo de chat redacta: le preguntas y compone una respuesta en texto que después hay que interpretar. Kev se parece más a un juez con una plantilla de puntuación. Quien hace la pregunta fija de antemano las opciones, y el modelo reparte el 100 % de su creencia entre ellas.
Le envías un texto (un correo, un ticket, un formulario) y un conjunto de preguntas, y te devuelve un número por cada respuesta posible, algo como «47 % devoluciones, 28 % envíos, 25 % facturación», que un programa puede usar directamente.
Admite tres tipos de pregunta:
- Sí o no («¿necesita atención urgente?»): devuelve la probabilidad del sí.
- Elegir una opción entre hasta 255 («¿qué equipo debe atenderlo?»): una probabilidad por opción y una confianza, que mide cuánto supera la opción ganadora a elegir al azar.
- Valorar en una escala («¿cómo de enfadado está el cliente?»): un nivel medio, ponderado por probabilidad.
Puede equivocarse como cualquier modelo, pero cada respuesta llega con una medida de cuánto se fía de ella, y esa medida se puede comprobar con datos.
Kev es una réplica abierta de Jev, un servicio comercial que la empresa TypeSafe llama modelo System One. Lo publicó el desarrollador Jared Palmer con la misma API, y según su repositorio el cliente oficial de TypeSafe para Python funciona contra un servidor de Kev sin cambios.
El código y los modelos base tienen licencia Apache 2.0, que permite el uso comercial, y Kev se ejecuta en una máquina propia.
Por qué una probabilidad vale más que una etiqueta
Con una etiqueta sola, cada ticket va al equipo que el modelo nombró y los errores quedan invisibles hasta que un cliente se queja.
Con números fiables, en cambio, puedes escribir una regla de negocio sobre la confianza de cada respuesta: automatiza lo que supere, por ejemplo, 0,80 y manda el resto a una cola humana. Así mides cuánto trabajo automatizaste y con qué tasa de error.
Eso exige que la confianza sea fiable, y hay que comprobarlo con datos propios, porque la calibración que trae Kev viene de los datos de sus autores.
El informe resume así las diferencias con pedirle un JSON a un modelo de chat:
| Modelo de chat con JSON | Kev | |
|---|---|---|
| Salida | Texto que hay que interpretar | Una probabilidad por opción |
| Respuestas inválidas | Posibles, hay que validarlas | Imposibles: solo elige entre las opciones dadas |
| Confianza | Inventada, si se pide | Calculada; el proyecto mide cuánto se ajusta al acierto real |
| Coste de cinco preguntas | Unas cinco veces la salida | Casi lo mismo que una |
| Inyección entre preguntas | Posible | Bloqueada por la arquitectura |
| Razonamiento abierto | Sí | No |
Cómo funciona por dentro
Técnicamente, Kev-4B, el modelo que probamos, es un adaptador pequeño (un LoRA) montado sobre un modelo abierto de la familia Qwen, de Alibaba, que se queda congelado. Entrenado así, ocupa unas decenas de megas encima de ese modelo base. El más grande de la familia, Kev-27B, reentrena en cambio el modelo entero.
Un modelo de chat escribe su respuesta pieza a pieza, y cada pieza le exige otra pasada completa por la red. Kev calcula las respuestas sin escribir nada. Procesa el documento una vez, lo guarda en una caché y lo reutiliza para cada pregunta, por lo que, según el informe, cinco preguntas cuestan más o menos lo mismo que una.
Cada pregunta lee el documento y su propio enunciado, y nada más. Kev ejecuta cada una como una secuencia independiente sobre ese documento en caché, de modo que una pregunta no puede leer el texto de otra.
Al final de cada pregunta, un componente pequeño compara la pregunta con cada opción y convierte esas puntuaciones en porcentajes. Como el modelo señala las opciones en vez de escribirlas, puedes añadir hoy una categoría nueva, por ejemplo requiere_revision_legal, y el modelo la puntuará sin reentrenarlo.
Lo que medimos en nuestro hardware
Ejecutamos Kev-4B, la versión de 4.000 millones de parámetros, en un Mac con chip M4 Pro y 24 GB de memoria, con el modelo publicado el 24 de septiembre de 2026 y el motor MLX en media precisión.
Una petición de tres preguntas sobre un ticket corto tardó 190 milisegundos; la evaluación de la que partimos, en una NVIDIA RTX 3090 Ti, había medido 46. Donde nuestras cifras difieren de las suyas lo decimos.
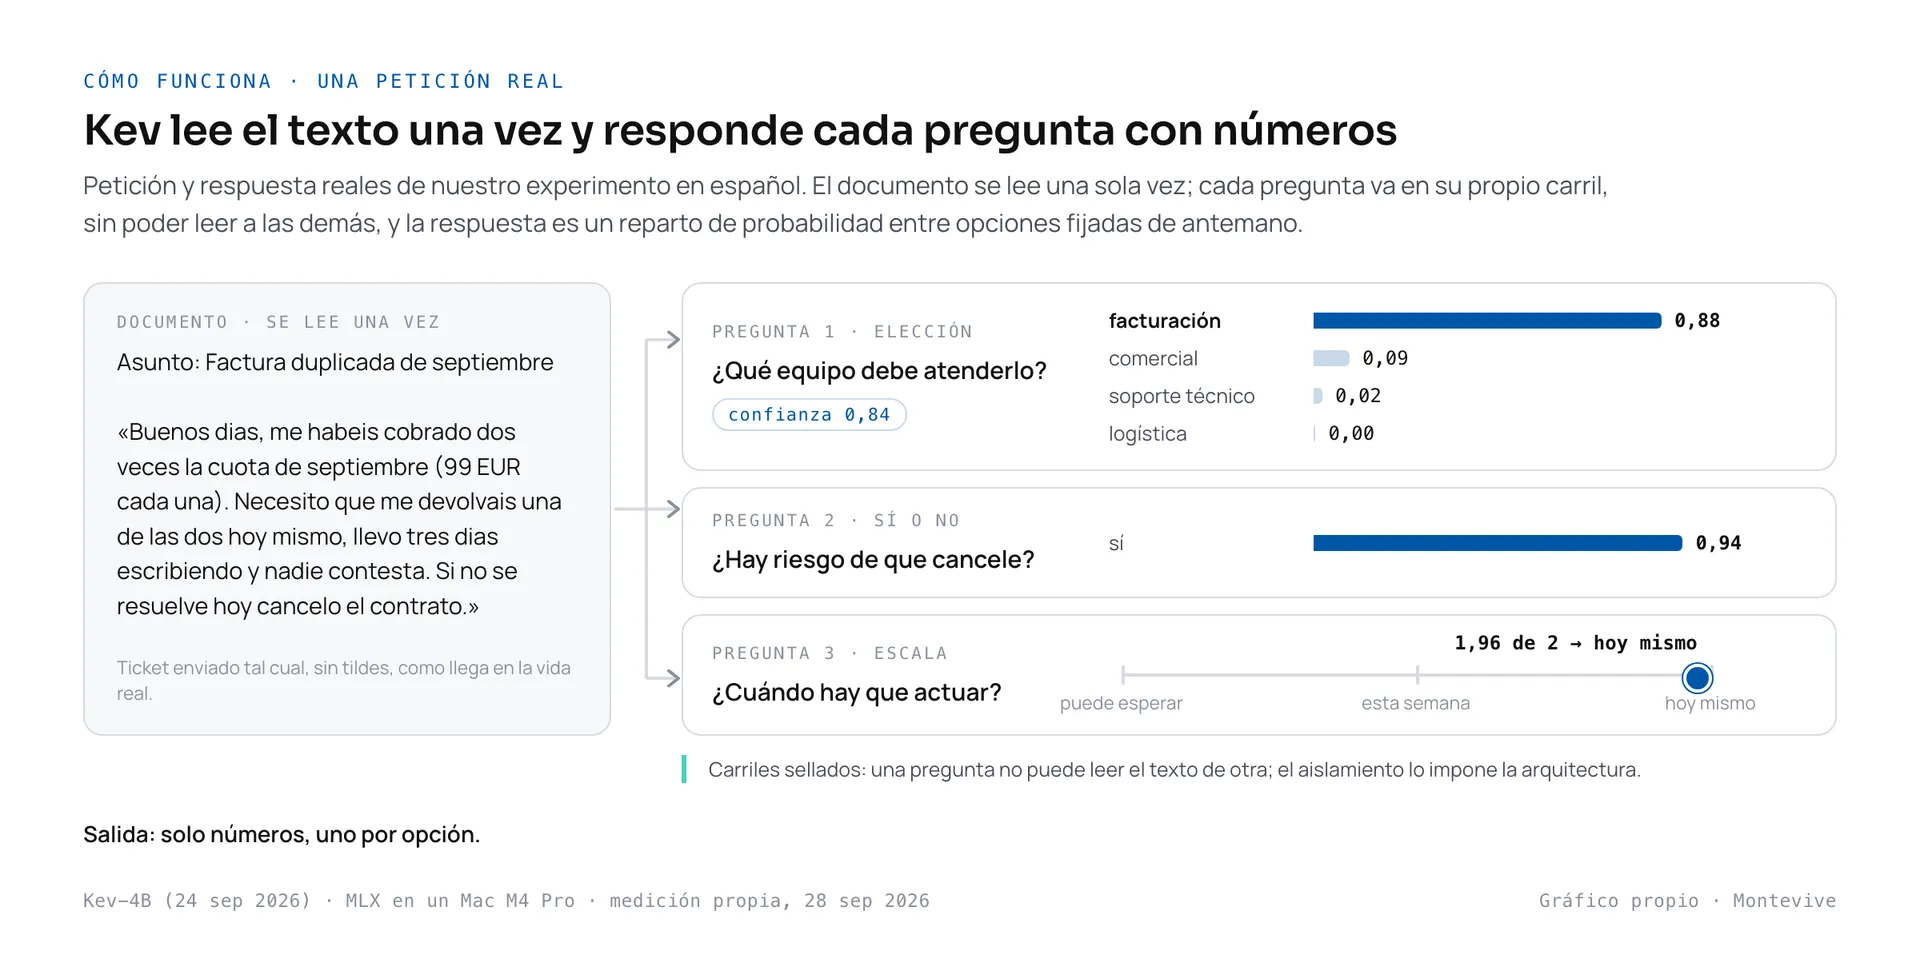
Le enviamos en castellano la reclamación de un cliente al que habían cobrado dos veces la cuota de septiembre y que terminaba con «si no se resuelve hoy cancelo el contrato». Kev se entrenó con diez conjuntos de datos en inglés y aun así acertó las tres preguntas.
Clasificó el ticket en facturación (probabilidad 0,88, confianza 0,84), marcó la urgencia como «hoy mismo» y dio un riesgo de baja de 0,94, conectando «cancelo el contrato» con una pregunta formulada de otra manera. La evaluación original había obtenido los mismos resultados, con diferencias de centésimas.
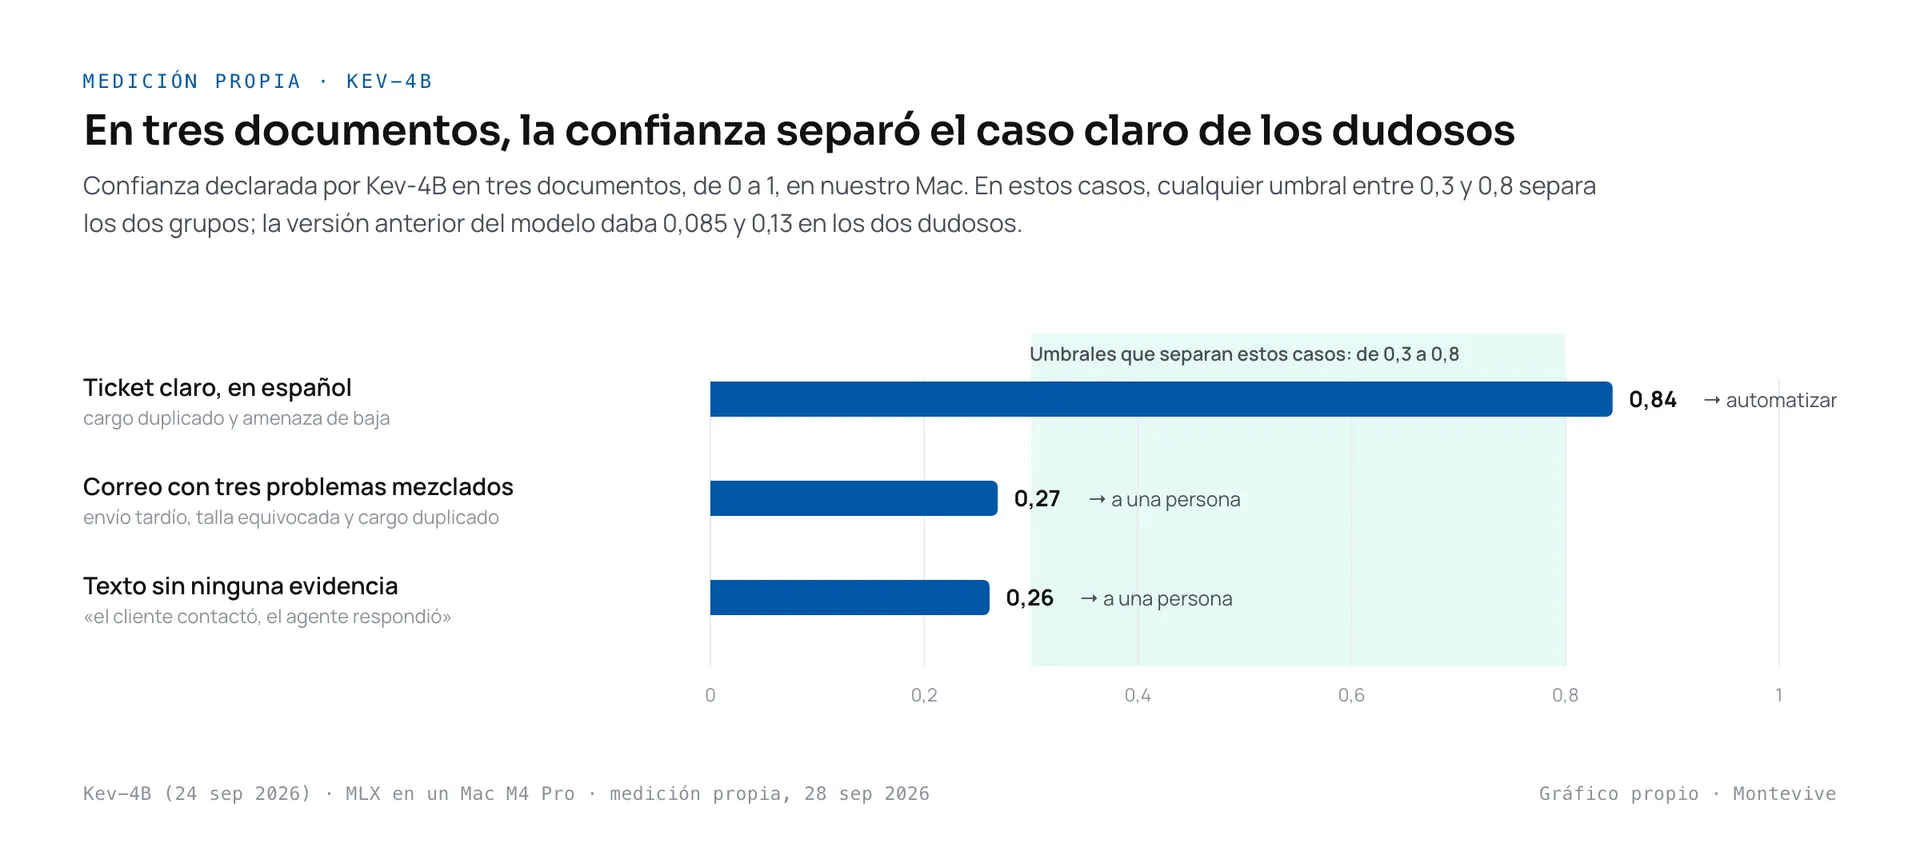
Ante un correo que mezclaba un envío tardío, una talla equivocada y un cargo duplicado, Kev repartió su creencia entre devoluciones (0,51), envíos (0,36) y facturación (0,13), con una confianza de 0,27. Ante un texto sin ningún dato útil, la confianza fue de 0,26.
En estos tres documentos, cualquier umbral de confianza entre 0,3 y 0,8 separa el ticket claro de los dos dudosos.
Aquí apareció la primera sorpresa. La evaluación de la que partimos, hecha tres días antes con la versión anterior del modelo, había medido 0,085 en ese mismo correo ambiguo y 0,13 en el texto sin datos.
La versión del 24 de septiembre está más segura justo donde no debería. Un umbral hay que medirlo con la versión que vayas a desplegar, y volver a medirlo cuando cambie.
Tres documentos no bastan para fijar un umbral. Además, los números de confianza de Kev están ajustados con los datos de sus autores, y según el propio proyecto, en un conjunto de datos externo el modelo declaró una confianza media de 0,82 cuando acertaba el 0,70.
Antes de fiarte de un umbral hay que reajustar la calibración con unos cientos de ejemplos tuyos, con la herramienta que trae el repositorio.
En la prueba de seguridad metimos en una pregunta un secreto y una instrucción para secuestrar el modelo, y pedimos a otra que revelara el secreto. Respondió «desconocido» con 0,69.
Repetida en solitario, esa segunda pregunta dio las mismas probabilidades con diferencias por debajo de 0,004, el ruido de calcular en lotes distintos; en la GPU de la evaluación original las cifras fueron idénticas hasta el cuarto decimal.
En ningún caso se filtró el secreto: el diseño no deja camino para que la información pase de una pregunta a otra.
Con un relato de negocio de unas 600 palabras acertó el riesgo de baja (0,94), el cargo duplicado sin devolver (0,99) y que no hacía falta revisión legal (0,05).
En «quién debe llevar la siguiente acción» dudó entre facturación y comercial, con confianza 0,26: justo lo que un umbral mandaría a una persona. Tardó 640 ms la primera vez y 285 la segunda, con el documento ya en caché.
En qué escenarios encaja en una empresa
Kev encaja en procesos con textos cortos o medianos, un conjunto fijo de preguntas y una forma de mandar los casos dudosos a una persona. Ese último requisito es la supervisión humana que defendíamos al analizar la multa de 825 millones a Uber, y aquí la marca el umbral de confianza.
| Escenario | Preguntas típicas |
|---|---|
| Triaje de soporte | ¿Qué equipo debe atenderlo? ¿Es urgente? ¿Cómo de enfadado está el cliente? |
| Riesgo de baja | ¿Hay intención de cancelar? ¿Menciona a la competencia? |
| Revisión previa de reclamaciones | ¿Hay un cargo duplicado sin devolver? ¿Necesita revisión legal? |
| Enrutado de formularios y solicitudes | ¿Qué tipo de solicitud es? ¿Falta información para tramitarla? |
| Análisis de conversaciones | ¿Se resolvió la consulta? ¿Hace falta un seguimiento? |
Tiene más sentido todavía cuando los datos no deberían salir de casa, como en despachos, clínicas o entidades financieras. Igual que cuando pusimos ALIA a funcionar en local, con IA soberana en tus propios servidores el texto se clasifica sin viajar a ningún tercero.
Kev frente a Jev: acierto, coste y control
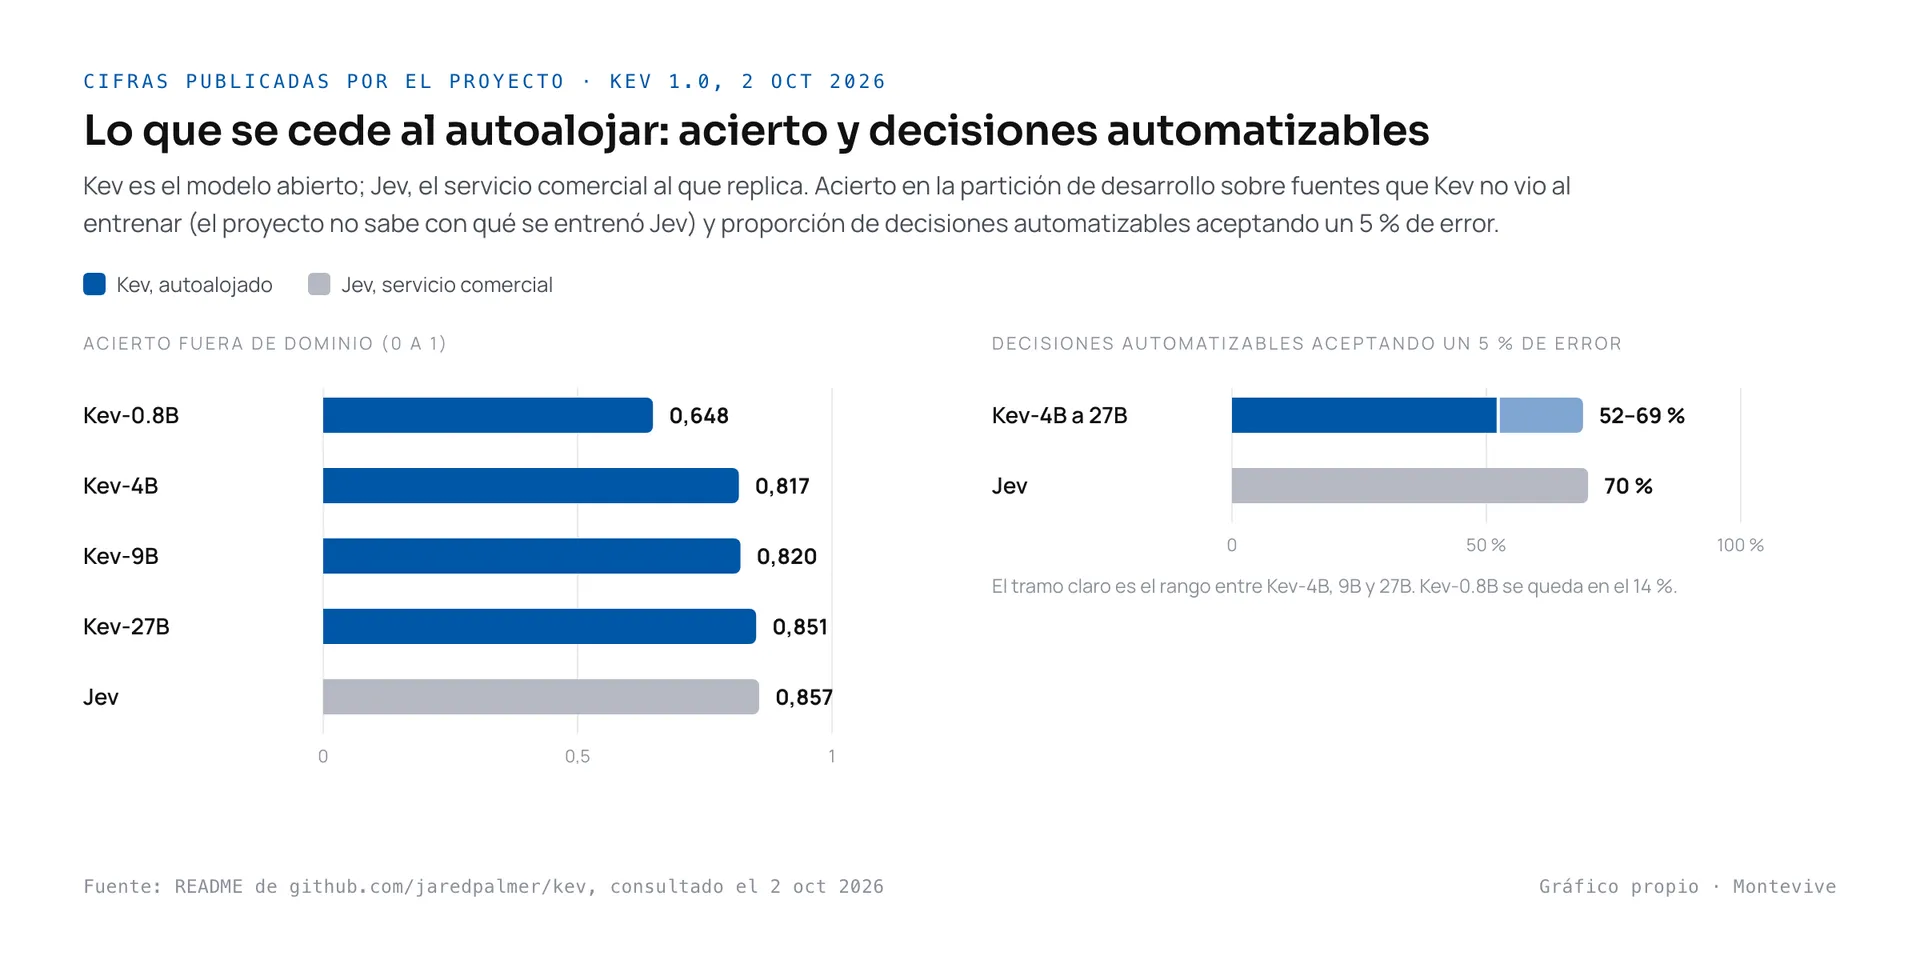
Acierto. Según las cifras que publica el proyecto, sobre conjuntos de datos que Kev no vio al entrenar, Kev-4B acierta el 0,817 de las preguntas, Kev-9B el 0,820 y Kev-27B el 0,851, frente al 0,857 de Jev. El proyecto advierte de que no sabe con qué datos se entrenó Jev, así que la comparación no es controlada.
Para decidir cuánto automatizar sirve más otra cifra. Según las mediciones del propio proyecto, si se acepta una tasa de error del 5 %, Kev-4B, 9B y 27B permiten automatizar entre el 52 % y el 69 % de las decisiones, y Jev el 70 %.
Coste. Jev cobra 0,042 dólares por millón de tokens de entrada y no cobra la salida. Cada petición del ejemplo ocupa unos 300 tokens contando las preguntas, así que los 4.000 correos diarios suman unos 36 millones al mes y cuestan alrededor de 1,5 dólares. Diez veces más volumen deja la factura por debajo de 20 dólares.
Kev-4B ocupó 8,6 GB de memoria de vídeo en la evaluación, y en nuestro Mac de 24 GB funcionó con holgura. El informe calcula que, a 46 ms por petición, una tarjeta de consumo de 24 GB da para del orden de un millón de peticiones cortas al día si se mantiene ocupada.
Estimamos una tarjeta de esa gama entre 600 y 2.000 euros según modelo y estado, más entre 30 y 65 euros al mes de electricidad si trabaja las 24 horas. Sin GPU, Kev da las mismas respuestas en el procesador, entre 20 y 54 veces más despacio según la evaluación; en un Mac con Apple Silicon usa MLX y va del orden de cuatro veces más lento que en la RTX 3090 Ti.
A eso se suma el tiempo de quien lo despliega, lo vigila y lo recalibra. A estos volúmenes, una sola jornada de trabajo técnico al año ya cuesta más que la factura anual de Jev.
Control. Autoalojando, el texto no sale de tu infraestructura y puedes ajustar el modelo con tus datos y auditar su código. Si el proyecto se abandona, el código y los pesos siguen en tu servidor; si un servicio cambia de precio o cierra, dependes de lo que decida su dueño. Si nada de eso pesa en tu caso, Jev es más barato y acierta más.
Dónde no encaja
Kev no es un asistente de propósito general. Nuestras pruebas, la evaluación de la que partimos y la documentación del proyecto coinciden en estos límites:
- Documentos largos. Se entrenó con textos de hasta unas 280 palabras. Acepta más, pero según el proyecto el acierto cae de forma visible en documentos largos, y lo tiene registrado como incidencia abierta. Nuestro relato de 600 palabras salió bien; es un caso, no una prueba.
- Preguntas que exigen saber del mundo en lugar de leer el texto que tiene delante. En preguntas de conocimiento general, según el proyecto, Jev saca 0,90 y Kev 0,74.
- Texto malicioso dentro del documento. El aislamiento protege a unas preguntas de otras, pero todas leen el documento por diseño. Si un cliente escribe «ignora tus instrucciones» en su correo, esa frase llega a todas las preguntas. Es la misma familia de ataque que explicamos con los navegadores con IA, y hay que tenerla en cuenta siempre que el texto venga de fuera.
- Casos reñidos. Probamos seis órdenes de las opciones. En un caso claro la ganadora se mantuvo, con probabilidad entre 0,98 y 0,99; en el correo ambiguo también se mantuvo, pero su probabilidad osciló 0,14 según el orden, y la evaluación de la versión anterior vio cambiar la ganadora en ese mismo correo. Un umbral de confianza filtra estos casos, y el repositorio permite promediar sobre varios órdenes.
- Fechas. No sabe restar fechas. El proyecto incluye un preprocesado opcional que calcula los días y los escribe en el texto; hay que activarlo.
- Una petición cada vez. Su servidor no agrupa peticiones de distintos clientes. Con tráfico real hay que levantar varias copias o poner una cola delante.
- Madurez. Es un proyecto de una sola persona. Su repositorio se creó el 17 de septiembre de 2026, dos días después del anuncio de Jev, y depende de librerías que cambian deprisa. El 1 de octubre publicó Kev 1.0, que fija una versión de cada modelo, un paso hacia la estabilidad. El informe advierte además de que clona la API de un producto comercial; lo considera legítimo, pero conviene saberlo antes de construir un negocio encima. Valora como alta su disciplina de ingeniería, y aun así depender de un proyecto tan joven es un riesgo.
Cómo hacer un piloto
Reproducir los experimentos de este artículo nos llevó una tarde en un Mac, la mayor parte descargando el modelo. El piloto añade el etiquetado de unos cientos de casos reales, que lleva el tiempo de alguien que conozca el proceso.
- Elige un proceso con textos cortos y preguntas fijas, donde hoy alguien lea y decida.
- Etiqueta unos cientos de casos reales y aparta entre un 10 y un 20 % para evaluar.
- Reajusta la calibración con tus datos.
- Mide qué parte de las decisiones podrías automatizar con una tasa de error que puedas defender, y cuál tendría que seguir pasando por una persona.
Si el acierto se queda corto, el proyecto recomienda ajustar el modelo con tus ejemplos partiendo del modelo ya publicado, porque empezar desde el modelo base pierde lo que Kev ya aprendió sobre este formato de preguntas.
Para comprobarlo tú mismo hacen falta tres órdenes (Python 3.12 o 3.13 y uv):
git clone https://github.com/jaredpalmer/kev.git && cd kev
uv sync --extra serve
uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009
¿En tu empresa alguien lee textos cada día para decidir a dónde van? Ese proceso es un buen candidato. Cuéntanoslo y, con una muestra de tus propios tickets, te decimos qué parte podrías automatizar y con qué tasa de error.
Fuentes
- Repositorio de Kev, creado el 17 de septiembre de 2026, versión Kev 1.0 del 1 de octubre: código, evaluaciones y licencia Apache 2.0 — github.com/jaredpalmer/kev
- Modelos de Kev publicados — huggingface.co/jaredpalmer
- Tarifa y fecha de Jev: anuncio de TypeSafe del 15 de septiembre de 2026 (0,042 $ por millón de tokens de entrada, salida gratis), consultado el 26 de septiembre de 2026 — typesafe.ai
- Evaluación técnica «Kev, explicado desde cero» (23 de septiembre de 2026, commit 557598f, Kev-4B en una NVIDIA RTX 3090 Ti): documento no publicado al que tuvimos acceso y cuyos experimentos reprodujimos.
- Mediciones propias: Kev-4B publicado el 24 de septiembre de 2026, MLX en media precisión, Mac con chip M4 Pro y 24 GB, 28 de septiembre de 2026. Guardamos las peticiones y las respuestas de cada prueba.
Mediciones propias del 28 de septiembre de 2026, cifras del proyecto consultadas el 2 de octubre y tarifa de Jev consultada el 26 de septiembre. El proyecto evoluciona deprisa: entre dos versiones publicadas con tres días de diferencia cambió la confianza en los casos ambiguos.