Ontologías para agentes de IA: qué son y cuándo tu empresa necesita una
Read this article in English.
En corto. Una ontología es una descripción formal de los conceptos de un negocio, de cómo se relacionan y de las reglas que permiten deducir lo que no está guardado en ninguna tabla. Ayuda a que un agente de IA no se invente relaciones entre datos, pero casi nunca es lo primero que necesita. Antes hacen falta dos cosas más sencillas: un esquema de datos bien documentado y una definición única de cada término del negocio.
Índice
- Qué es una ontología, en cristiano
- Ontología, grafo de conocimiento y capa semántica no son lo mismo
- Por qué tu agente se equivoca con los datos de tu empresa
- Lo que hemos visto en nuestros proyectos
- Lo que dicen las pruebas publicadas
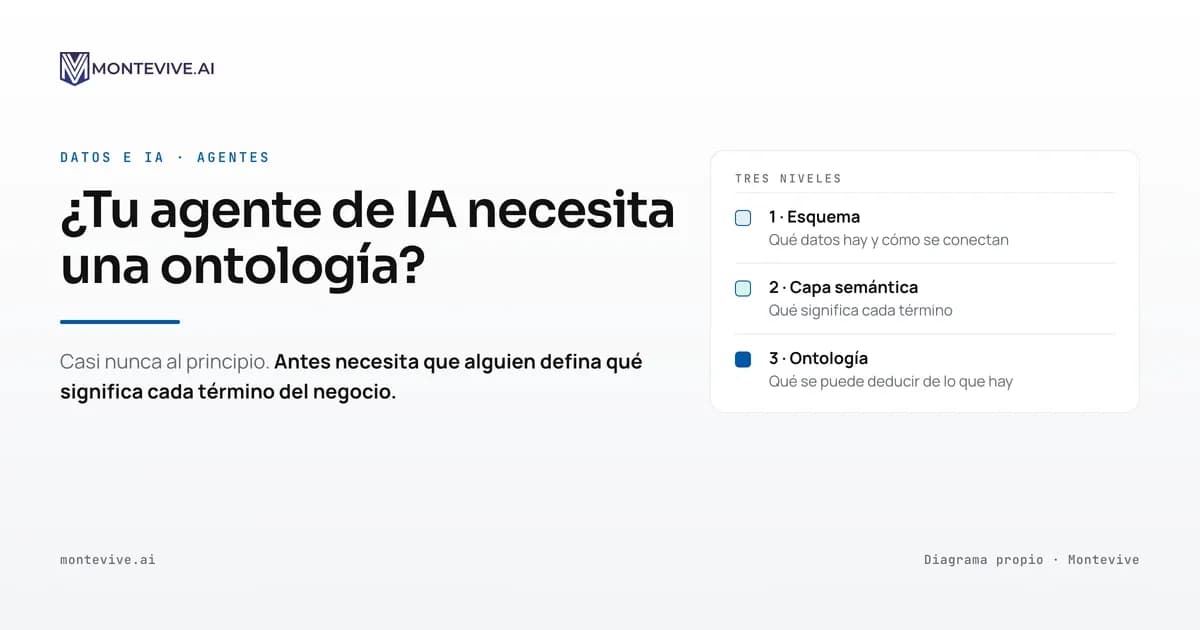
- Tres niveles: sube solo cuando lo necesites
- Cuándo sí compensa una ontología
- Lo que una ontología no hace
- Qué hacer antes de pensar en una ontología
- La pregunta que importa
- Fuentes
Le preguntas a tu agente de IA cuántas facturas tienes pendientes de pago con un proveedor. Responde en dos segundos, con una cifra y una tabla impecable. La cifra está mal, y nadie se da cuenta hasta el cierre del mes.
Cuando pasa esto, la respuesta de moda es añadir una ontología o un grafo de conocimiento. A veces es la solución. En los proyectos que vemos, el problema suele ser anterior y más aburrido: nadie ha escrito en ningún sitio qué significa «pendiente de pago» en tu empresa.
Brijesh Dave lo plantea en un artículo reciente: muchos proyectos montan ontologías que no necesitan, cuando les bastaría con modelos de datos bien documentados, relaciones claras y validaciones. Propone tres niveles y subir de uno a otro solo cuando la complejidad lo justifique.
Qué es una ontología, en cristiano
Una base de datos guarda información. Una ontología describe qué significa esa información, cómo se relaciona y qué se puede deducir de ella.
Piensa en una distribuidora eléctrica. Maneja clientes, contratos, puntos de suministro, transformadores e incidencias. Su base de datos tiene una tabla para cada cosa, unidas por claves. Una ontología escribe además las reglas del negocio:
- Un contrato está asociado a un punto de suministro.
- Cada punto de suministro se identifica por su CUPS, el código universal que lo distingue.
- Un transformador alimenta a varios puntos de suministro.
- Todo transformador es un equipo eléctrico.
- Si un equipo alimenta un punto de suministro y un contrato está asociado a ese punto, el contrato depende de ese equipo.
La última regla es la que marca la diferencia. Con SQL también se pueden encontrar los contratos que cuelgan del transformador T-103, pero alguien tiene que escribir esa consulta, y repetir la lógica en cada informe o cada agente que la necesite. En la ontología, la regla se declara una vez y sirve para cualquier pregunta.
Si además se declara que «alimenta» encadena (la subestación alimenta la línea, la línea el transformador y el transformador el punto), la misma regla encuentra los contratos afectados por una avería en cualquier punto de la red, sin escribir una consulta nueva para cada nivel.
Diagrama propio · Montevive. Ejemplo simplificado; los identificadores son inventados.
Cómo lo deduce una máquina
Los estándares más usados para escribir ontologías son del W3C, el consorcio que mantiene los estándares de la web.
RDF guarda cada hecho como un triple de sujeto, predicado y objeto: «T-103 alimenta P-52». OWL añade el significado: jerarquías («todo transformador es un equipo eléctrico»), relaciones inversas («alimentado por» es lo contrario de «alimenta»), relaciones que encadenan y reglas como la de los contratos.
Un razonador, un programa que aplica esas definiciones con lógica formal, concluye que T-103 es un equipo eléctrico y que C-881 depende de T-103, aunque nadie lo haya guardado. No es la predicción de un modelo de lenguaje: el mismo razonamiento da siempre el mismo resultado, y se puede explicar paso a paso por qué el sistema dio por afectado un contrato.
Ontología, grafo de conocimiento y capa semántica no son lo mismo
Los tres términos se usan como sinónimos y no lo son. Cada uno cuesta y resuelve cosas distintas.
| Concepto | Qué aporta | Ejemplo |
|---|---|---|
| Esquema de datos | Estructura, tipos y relaciones entre tablas | La tabla contratos tiene un campo cups |
| Capa semántica | Una definición única de los términos y las métricas del negocio | Qué es exactamente un «cliente activo» y cómo se cuenta |
| Grafo de conocimiento | Hechos concretos conectados entre sí | El cliente A tiene el contrato B |
| Ontología | El modelo formal de conceptos, relaciones y reglas lógicas | Todo contrato de suministro se vincula a un punto de suministro |
Simplificando mucho, la ontología son las reglas del mundo, y el grafo de conocimiento, el mapa de los hechos concretos de ese mundo. En la práctica muchos grafos llevan su ontología dentro, y muchos otros son solo datos conectados, sin reglas.
Por qué tu agente se equivoca con los datos de tu empresa
Un agente con un modelo de lenguaje funciona de maravilla en la demo, con una tabla limpia. Cuando empieza a consultar varias bases de datos, el ERP y un par de APIs, aparecen los errores que describe Dave:
- Confunde conceptos de negocio.
- Se inventa relaciones entre tablas.
- Interpreta mal el estado de una operación.
- Escribe consultas SQL que funcionan y devuelven lo que no era.
- No sabe que dos departamentos llaman distinto a lo mismo.
El problema visible es que el modelo se inventa cosas. El problema real, en nuestra experiencia, es que el significado de los datos no está escrito: vive en la cabeza de unas pocas personas y en consultas antiguas. El modelo rellena ese hueco con lo que le parece plausible.
Lo que hemos visto en nuestros proyectos
Dos ejemplos de las últimas semanas, de agentes y automatizaciones que montamos para clientes.
En un proyecto de recobros, el correo de impago tenía que decir cuánto se debe. La responsable del área cambió tres veces en una semana la regla de qué cuenta como «importe adeudado»: qué estados entran, si cuenta lo vencido o también lo futuro, y qué parte de lo que ya es incobrable. Es el mismo problema que el de las facturas pendientes del principio, y ningún modelo podía adivinar la versión final.
En otro proyecto, una plataforma que genera contratos llamaba a las mismas categorías de gasto de una forma en la aplicación y de otra en la tabla del contrato, y el documento acababa contradiciéndose. Lo arreglamos dejando un único nombre por concepto, acordado con el cliente y usado en todas partes.
Ninguno de los dos necesitaba una ontología. Necesitaban que alguien con autoridad decidiera qué significa cada término, y que el sistema usara esa definición y no otra.
Lo que dicen las pruebas publicadas
Hay una serie de estudios que miden justo esto: cuántas preguntas de negocio responde bien un modelo de lenguaje sobre la base de datos de una empresa, según qué contexto le des. Usan siempre el mismo caso, una aseguradora ficticia con su base de datos y un juego de preguntas como las que haría un directivo.
- 2023. Juan Sequeda, Dean Allemang y Bryon Jacob, de data.world, midieron que GPT-4 acertaba el 16 % de las preguntas consultando directamente las tablas. Con los mismos datos representados como grafo de conocimiento, el 54 %.
- 2024. Allemang y Sequeda añadieron una comprobación basada en la ontología, sin modelo de lenguaje, que revisa cada consulta antes de ejecutarla y pide al modelo que la corrija si no encaja. El 72,6 % de las respuestas salieron bien, el 8 % fueron un «no lo sé» y alrededor del 20 %, erróneas.
- 2026. dbt Labs tomó 11 preguntas de ese caso y las repitió 20 veces con dos modelos, Claude Sonnet 4.6 y GPT-5.3-Codex. Con la base de datos original, dejar que el modelo escribiera la consulta acertó el 64,5 % con los dos, y la capa semántica, el 72,7 %. Después añadieron tres tablas intermedias que ordenaban los datos para el negocio, y el acierto subió en los dos métodos: entre el 84 y el 90 % escribiendo la consulta, y entre el 98 y el 100 % con la capa semántica.
Gráfico propio · Montevive, con los datos de las tres publicaciones citadas. Los modelos y los montajes cambian entre estudios: compara dentro de cada bloque, no entre bloques.
Conviene leer estas cifras con cautela. Es un solo caso, con pocas preguntas: con 11, cada pregunta mueve el resultado nueve puntos. Data.world vende grafos de conocimiento y dbt Labs vende una capa semántica. Y ningún estudio mide lo que cuesta construir y mantener cada capa.
Aun así, dejan dos lecturas. La primera: en este caso, darle al agente el significado del negocio, en forma de grafo, de ontología o de capa semántica, mejoró mucho sus respuestas. La segunda, menos citada: en el estudio de dbt, el salto más grande no vino de añadir una capa, sino de ordenar mejor los datos.
Los autores de dbt subrayan algo más: cuando la capa semántica no puede responder una pregunta, lo dice, en vez de devolver datos erróneos en silencio.
Tres niveles: sube solo cuando lo necesites
La propuesta de Dave se resume en una escalera.
Diagrama propio · Montevive, a partir de los tres niveles que propone Brijesh Dave. El coste relativo es una estimación nuestra.
Esta es nuestra lectura, a partir de la de Dave, de por dónde empezar según el tipo de agente:
| Situación | Por dónde empezar | Nivel |
|---|---|---|
| Un agente que consulta una base de datos bien estructurada | Esquema documentado y validaciones | 1 |
| Un agente que genera informes y calcula indicadores | Capa semántica | 2 |
| Varios sistemas que llaman distinto al mismo concepto | Capa semántica común | 2 |
| Un agente que recorre relaciones complejas entre entidades | Grafo de conocimiento, si las preguntas lo justifican | 2-3 |
| Un agente de cumplimiento con clasificaciones normativas y razonamiento formal | Ontología | 3 |
La frontera es menos rígida de lo que parece en una tabla, porque se puede tener un modelo ontológico ligero sin RDF ni OWL. Lo que no conviene es saltarse los niveles de abajo.
Cuándo sí compensa una ontología
Según Dave, y coincide con lo que vemos, una ontología formal tiene sentido cuando se juntan tres cosas:
- Un dominio con jerarquías y clasificaciones complejas, como la regulación, los seguros, la salud o la energía.
- Varios sistemas o áreas que hay que integrar, con conocimiento que se quiere reutilizar en más de un agente.
- Conclusiones que tienen que poder auditarse: no basta con que el agente acierte, hay que poder explicar por qué llegó ahí.
El ejemplo más claro es un agente de cumplimiento. Para decidir qué obligaciones aplican, tiene que relacionar el tipo de dato, la finalidad del tratamiento, si es una categoría especial, la norma aplicable y la categoría del sistema de IA. Esas relaciones cambian menos que los datos, tienen jerarquías y conviene que no las improvise el modelo de lenguaje en cada pregunta.
Ahí funciona bien repartir el trabajo en tres piezas. El modelo de lenguaje interpreta lo que pide la persona. La ontología guarda los conceptos y sus relaciones. Y un conjunto de reglas aparte, que no depende del modelo, decide qué está permitido, exigido o prohibido.
Es el mismo reparto que aplicamos en Moviwa, nuestra capa de seguridad entre los equipos y la IA: el modelo detecta qué tipo de dato lleva un mensaje, y qué se hace con él lo deciden las políticas que define cada empresa.
Lo que una ontología no hace
- No arregla datos malos. Deduce a partir de lo que hay. Si el dato de qué transformador alimenta qué punto está mal, la deducción será impecable y falsa.
- No se mantiene sola. Cada cambio de negocio o de norma hay que reflejarlo, y una ontología grande puede acabar con reglas que se contradicen.
- Añade piezas. Un lenguaje de consultas propio, un razonador y alguien que sepa mantener las dos cosas.
- No garantiza el cumplimiento normativo. Ayuda a aplicar reglas, pero las obligaciones hay que mantenerlas al día y aplicarlas con su contexto jurídico.
- No sustituye a quien decide qué significa cada término. Solo lo deja escrito de forma que una máquina pueda usarlo.
Qué hacer antes de pensar en una ontología
- Escribe las 20 preguntas que tu agente tiene que responder bien. Las reales, las que hoy alguien resuelve a mano.
- Define cada término de negocio que aparece en esas preguntas, con un responsable que firme la definición.
- Elige una fuente por concepto. Si «cliente activo» sale de dos sistemas, decide cuál manda.
- No dejes que el agente escriba SQL libre contra tus sistemas. Dale consultas e indicadores ya definidos, con sus permisos, y comprueba lo que entra y lo que sale. Es también una cuestión de seguridad, como contamos en nuestro artículo sobre agentes autónomos.
- Mide con esas preguntas, y valora el «no lo sé». Un agente que reconoce que no sabe es más útil que uno que se equivoca con aplomo. Repite la medición cada vez que cambies algo.
Si después de eso el agente sigue fallando en preguntas que exigen deducir relaciones que no están guardadas, es el momento de evaluar un grafo de conocimiento o una ontología.
La pregunta que importa
La pregunta útil no es «¿mi agente necesita una ontología?», sino: ¿qué conclusiones necesita obtener el agente que no estén almacenadas explícitamente, y qué garantías necesito sobre esas conclusiones?
Si estás montando un agente sobre los datos de tu empresa, en gobierno del dato te ayudamos a preparar lo que necesita antes que cualquier tecnología. Si ya lo tienes funcionando, en la auditoría de agentes de IA medimos con tus preguntas reales dónde se equivoca. Escríbenos con las tres preguntas que tu agente responde peor y te decimos en qué nivel está el problema.
Fuentes
- Brijesh Dave, «Do your AI agents actually need an ontology layer, or just a better schema?», Intellytics Solutions (Medium), 23 de octubre de 2026.
- Juan Sequeda, Dean Allemang y Bryon Jacob, «A Benchmark to Understand the Role of Knowledge Graphs on Large Language Model's Accuracy for Question Answering on Enterprise SQL Databases», arXiv, noviembre de 2023.
- Dean Allemang y Juan Sequeda, «Increasing the LLM Accuracy for Question Answering: Ontologies to the Rescue!», arXiv, mayo de 2024.
- Jason Ganz y Benoit Perigaud, «Semantic Layer vs. Text-to-SQL: 2026 Benchmark Update», dbt Developer Blog, 7 de abril de 2026.
- W3C, «RDF 1.1 Concepts and Abstract Syntax», recomendación de 2014.
- W3C, «OWL 2 Web Ontology Language Document Overview», recomendación de 2012.
Recibe el Radar IA cada lunes
Las noticias de IA que importan a tu empresa, elegidas y resumidas en un correo breve. Te puedes dar de baja cuando quieras.