Jev frente a BERT: decidir mejor o decidir en casa
Read this article in English.
El 15 de septiembre de 2026, la empresa estadounidense TypeSafe presentó Jev, un modelo de IA que no escribe: lee un texto, elige entre las opciones que le das y te dice con qué seguridad lo hace. Lo hemos medido junto a Kev, su réplica abierta, con casi 500 textos, incluidos documentos reales del Boletín Oficial del Estado (BOE). Jev fue el que menos textos sensibles dejó pasar.
TypeSafe lo presenta por su velocidad y su precio. Para usarlo, eso sí, hay que mandarle el texto a sus servidores, que según su política de privacidad están en Estados Unidos. Y cuando la pregunta es si un texto puede salir de tu empresa, dónde se decide importa al menos tanto como lo bien que se decide.
Esa es la comparación que nos interesa con BERT, la familia de modelos pequeños que lleva desde 2018 decidiendo sobre textos sin escribir una palabra. Conviene decirlo desde el principio: en Moviwa, nuestro producto, usamos modelos de esta familia.
Qué son Jev y BERT, en dos minutos
Un asistente como ChatGPT redacta una respuesta. Jev no redacta nada. Le das un texto y unas opciones («público», «interno», «confidencial»…) y te devuelve la probabilidad de cada una. La pregunta se cambia en cada petición, sin entrenar nada.
Cobra 0,042 dólares por millón de tokens de entrada (los fragmentos de palabra con los que estos modelos miden el texto), y la salida es gratis. Todas las peticiones de nuestro estudio, algo más de 2.000 contando las pruebas de robustez, costaron 0,065 dólares. Está en acceso anticipado y funciona solo en la nube.
Kev, en cambio, se puede instalar en una máquina propia: la analizamos a fondo hace unas semanas.
BERT, que Google publicó en 2018, también decide sin escribir: lee un texto y le pone una etiqueta. Es pequeño, de 110 a 340 millones de parámetros en su versión original, frente a los miles de millones de un modelo de chat. Por eso responde en milisegundos en un procesador corriente, sin tarjeta gráfica, y puede funcionar en tu propio servidor.
A cambio, no sabe hacer tu tarea hasta que lo entrenas con ejemplos. Y lo bien que decida depende de esos ejemplos.
Lo que medimos
Pusimos a prueba a Jev y a Kev con la misma pregunta: a qué nivel de confidencialidad, de cinco, pertenece cada texto. Les dimos la misma guía con las definiciones de cada nivel, fijada en un protocolo que registramos antes de lanzar las pruebas, y dos grupos de textos:
- 329 textos inventados para la prueba: correos, mensajes de chat y fragmentos de documentos, con y sin información sensible. Los escribieron cuatro modelos de Anthropic (Claude Opus, Sonnet, Haiku y Fable) a partir de nuestras instrucciones. Tres de ellos (Opus, Sonnet y Fable), sin ver la respuesta esperada, confirmaron la etiqueta de cada uno y coincidieron en todos a la hora de decir si era sensible o no.
- 150 fragmentos reales del BOE de septiembre de 2026. Son públicos por definición, así que cualquier aviso de «confidencial» sobre ellos es una falsa alarma.
Contamos solo si cada texto acaba como sensible o no, porque esa es la decisión que importa para dejarlo salir, y dos errores:
- Una fuga es un texto sensible que el modelo deja pasar. Es el error que más daño hace.
- Una falsa alarma es un texto inofensivo que el modelo bloquea. No filtra nada, pero interrumpe a quien lo escribe sin motivo.
| Jev 1.13 | Kev-4B | |
|---|---|---|
| Textos sensibles que dejó pasar (de 140) | 1 | 8 |
| Falsas alarmas en textos inventados (de 189) | 0 | 0 |
| Falsas alarmas en el BOE (de 150) | 2 | 0 |
| Tiempo por texto (mediana) | 294 ms, con la red | 761 ms, en la tarjeta gráfica de un Mac |
Jev fue el que menos textos sensibles dejó pasar. Kev dejó pasar más, pero no dio ninguna falsa alarma, ni siquiera en el BOE. Con este número de textos, la diferencia en fugas entre los dos no llega a ser estadísticamente significativa: en una prueba apareada (McNemar, con corrección por comparaciones múltiples) da p = 0,06.
Las fugas se concentraron en el mismo tipo de texto: los secretos que lo son solo porque aún no se han publicado. Fueron 6 de las 8 de Kev y la única de Jev. Una oferta para una licitación, la tarifa pactada con un cliente o una OPA antes del anuncio se parecen mucho a cualquier texto de empresa. Ningún modelo sabe qué ha publicado ya tu empresa y qué no.
En la tabla no hay ningún modelo tipo BERT. Cada uno acierta según los ejemplos con que se entrena, así que no existe uno de referencia, y los que usamos en Moviwa son parte de un producto comercial cuyas cifras no publicamos. Por eso este artículo no dice que un modelo tipo BERT acierte tanto como Jev. Lo que sí sirve para cualquiera es el método: un banco de pruebas como este, con fugas y falsas alarmas por separado, antes de confiarle una decisión.
Lo que esta medición no dice
- No hay documentos confidenciales reales. Las fugas se midieron con textos inventados. La parte real, el BOE, solo mide falsas alarmas.
- Los textos inventados son demasiado claros. Pedimos textos de un nivel bien definido, y que los revisores coincidieran en todos lo confirma. Sirve para fijar las etiquetas, pero deja fuera los casos dudosos. Con mensajes reales, los dos modelos fallarán más.
- Generadores y revisores son modelos de una misma empresa, Anthropic, de su familia Claude. Ninguno es de TypeSafe. Es un sesgo que no hemos podido eliminar.
- La guía influye. Jev y Kev recibieron las mismas definiciones que los revisores, y eso les favorece. Probamos también otra redacción: Kev dio falsa alarma en 15 de los 150 documentos del BOE, y Jev pasó de 1 a 3 fugas.
- Los tiempos no salen de la misma máquina. Jev, con la red desde Granada; Kev, en la tarjeta gráfica de un Mac; el modelo tipo BERT, en el procesador del mismo Mac.
- Jev cambia. Medimos su versión 1.13 el 5 de octubre de 2026. Está en acceso anticipado, y sus resultados y condiciones pueden variar.
Por qué el que mejor decide no siempre te conviene
Que Jev decida bien no lo convierte en la mejor opción para cualquier empresa. Hay tres razones para pensarlo dos veces, y la primera es la que más pesa.
Para preguntarle, hay que enviárselo
Jev decide en los servidores de TypeSafe. Para saber si un mensaje lleva un secreto, tienes que mandárselo antes, entero.
Si lo que buscas es evitar que la información sensible salga de la empresa, enviarla fuera para preguntarlo es empezar por el final. Su política de privacidad dice que no entrena con lo que recibe, pero el texto sale igual.
Si esos textos llevan datos personales, el capítulo V del Reglamento General de Protección de Datos (RGPD) trata su envío a Estados Unidos como una transferencia internacional. Tu empresa tendría que comprobar con qué garantía se hace y documentarlo. Por ejemplo, si el destinatario está adherido al Marco de Privacidad de Datos UE-EE. UU. o si firma cláusulas contractuales tipo. Es lo primero que habría que preguntarle a TypeSafe.
Un modelo tipo BERT, en cambio, puede decidir dentro de tu infraestructura, sin que el texto pase por ningún proveedor externo.
Cada texto tiene que esperar la respuesta
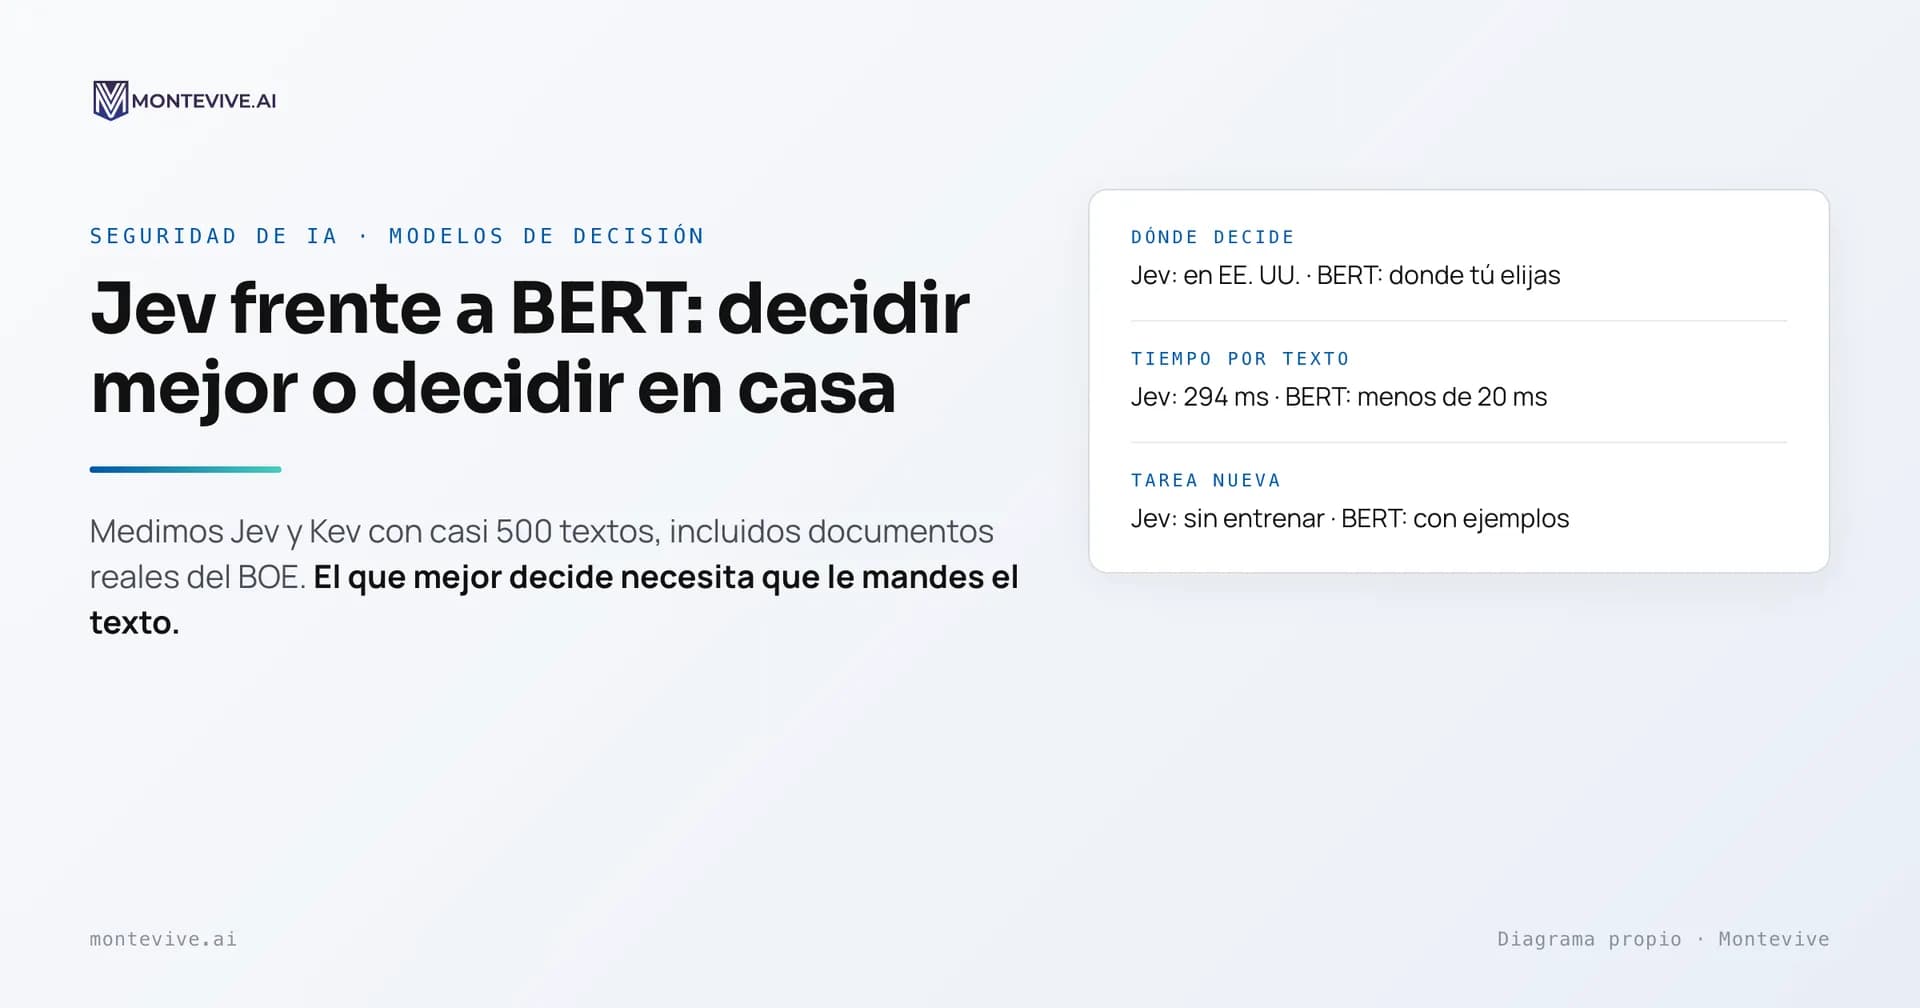
Si revisas cada mensaje antes de que salga, o cada documento antes de archivarlo, el tiempo de la decisión se suma a cada uno. En nuestra prueba, Jev tardó casi 300 milisegundos por texto, red incluida.
Kev pasó de 700 en la tarjeta gráfica de un Mac, y su propio proyecto calcula que en un procesador normal iría entre 20 y 54 veces más lento. En nuestras pruebas, un modelo tipo BERT ajustado tardó menos de 20 milisegundos de mediana en el procesador del mismo Mac, sin usar la tarjeta gráfica. Con documentos largos, como los del BOE, rondó los 100.
Un fichero que no cambia si no lo cambias tú
Jev es el servicio de una empresa joven, y su precio, su comportamiento y su continuidad dependen de ella. Un modelo tipo BERT ajustado es un fichero en tu servidor: da siempre la misma respuesta al mismo texto y solo cambia cuando lo reentrenas. Si un día hay que explicar por qué salió un documento, sabes qué versión lo decidió y puedes repetir la decisión.
¿Y Kev, que es abierto y se puede instalar en casa?
Kev cumple la primera razón y la tercera: puedes alojarlo donde quieras y es un fichero que controlas tú. Le falla la segunda. Necesita tarjeta gráfica para responder a tiempo. Por eso encaja mejor en otro papel: enseñar.
Un modelo grande enseña, uno pequeño decide
El gran inconveniente de un modelo tipo BERT son los ejemplos etiquetados. Reunirlos con documentos reales de la empresa es lento y delicado, porque son justo los que no deberían circular.
Un modelo grande puede hacer ese trabajo. Puede escribir miles de textos inventados de cada categoría, o etiquetar los que ya tienes. Para eso sirven un modelo público como ALIA, el del Estado español, Kev en tus propias máquinas o Jev, este último solo con textos que puedan salir.
Hay que pedirle también casos dudosos, porque los textos inventados tienden a ser demasiado claros. Con esos ejemplos se entrena el modelo pequeño, y antes de ponerlo a trabajar se comprueba con un banco de pruebas que incluya documentos reales.
Cuándo te conviene cada uno
| Jev | Kev | Un modelo pequeño tipo BERT | |
|---|---|---|---|
| Hay que entrenarlo | No | No | Sí, con ejemplos |
| Pregunta nueva | Se cambia en cada petición | Se cambia en cada petición | Hay que reentrenar |
| Dónde decide | En los servidores de TypeSafe | Donde lo instales | Donde lo instales |
| Qué necesita | Conexión a su servicio | Tarjeta gráfica | Un procesador corriente |
| Tiempo por texto en nuestra prueba | 294 ms | 761 ms | Menos de 20 ms |
| De quién dependes | De TypeSafe | De ti | De ti |
Jev encaja cuando tus categorías cambian a menudo, no tienes ejemplos y los textos pueden salir sin problema legal ni contractual. Kev, cuando tampoco tienes ejemplos pero los textos no pueden salir y tienes una tarjeta gráfica. Un modelo pequeño, cuando la pregunta es siempre la misma, el volumen es alto y necesitas auditar qué decide.
La pregunta que importa
Antes de elegir un modelo que decida sobre información sensible, conviene responder cuatro preguntas: cuánto acierta, quién lee los textos mientras decide, cuánto tarda y qué pasa si el proveedor cambia las condiciones. Jev gana en la primera. Un modelo pequeño en tu infraestructura gana en las otras tres. Cuando los textos son de tus clientes, por mucho que Jev acierte, nosotros priorizamos la seguridad de los datos.
Si estás eligiendo un modelo para clasificar o filtrar información sensible, lo medimos contigo como en esta prueba, separando las fugas de las falsas alarmas. Los modelos que se instalan en casa, con tus textos y en tu infraestructura; los de la nube, solo con textos que puedan salir. Es parte de nuestras auditorías de sistemas de IA. Cuéntanos tu caso.
Fuentes
- Anuncio de Jev: TypeSafe, «Introducing System One models and Jev», 15 de septiembre de 2026, consultado el 5 de octubre de 2026 — typesafe.ai
- Política de privacidad de TypeSafe, consultada el 5 de octubre de 2026 — typesafe.ai/legal/privacy-policy
- Repositorio de Kev, versión 1.0, licencia Apache 2.0 — github.com/jaredpalmer/kev
- Devlin, Chang, Lee y Toutanova, «BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding», 11 de octubre de 2018 — arxiv.org/abs/1810.04805
- Reglamento (UE) 2016/679 (RGPD), capítulo V, transferencias de datos personales a terceros países — eur-lex.europa.eu
- Decisión de Ejecución (UE) 2023/1795 de la Comisión, de 10 de julio de 2023, sobre el Marco de Privacidad de Datos UE-EE. UU. — eur-lex.europa.eu
- Boletín Oficial del Estado, ediciones de septiembre de 2026 — boe.es
- Medición propia de Montevive, 5 de octubre de 2026, no publicada: Jev 1.13 por su API y Kev-4B 1.0 en local, con 329 textos inventados y 150 fragmentos del BOE, y protocolo registrado antes de lanzar las pruebas; tiempos de un modelo tipo BERT ajustado en el procesador del mismo equipo.
Este artículo refleja el estado de Jev y del marco normativo a 8 de octubre de 2026. Tiene finalidad informativa y no sustituye asesoramiento legal.